El chat que usan abogados chaqueños y que la UNNE acaba de premiar
¿Qué tiene de distinto el sistema de inteligencia artificial que la UNNE desarrolló para el ámbito legal y que acaba de ser premiado en las JAIIO? La respuesta está en una decisión clave que evita las "alucinaciones".
Dos becarios de la UNNE recibieron un premio en las Jornadas Argentinas de Informática por un sistema de inteligencia artificial que responde consultas jurídicas sin "alucinar". El desarrollo ya se aplica en un proyecto con el Poder Judicial del Chaco y en convenios con startups del sector legal.
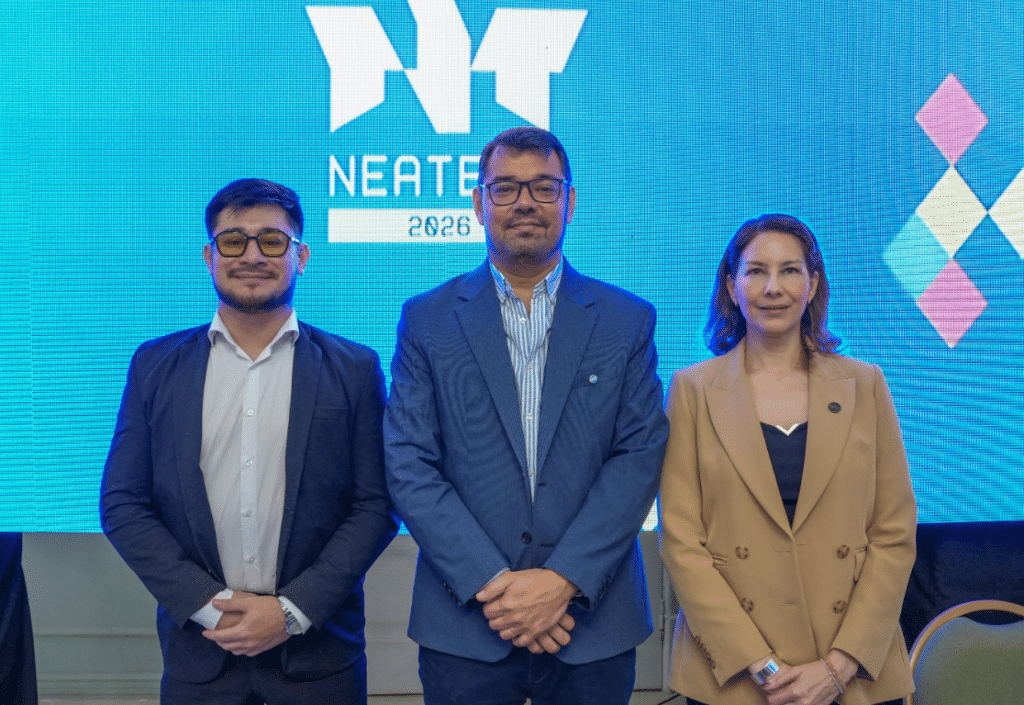
Federico Smulever y Luciana Belén Canteros, becarios del Área de Inteligencia Artificial de la Universidad Nacional del Nordeste (UNNE), se llevaron un reconocimiento en las 55 Jornadas Argentinas de Informática (JAIIO), que se realizaron en la Universidad Tecnológica Regional La Plata.
El trabajo se titula «Filtrado Estructurado por Metadatos como Estrategia de Refinamiento de la Búsqueda Semántica en Sistemas RAG para el Dominio Legal» y forma parte de una línea de investigación del Área de Machine Learning e Inteligencia Artificial de la FaCENA UNNE, que dirigen los doctores Manuel Pulido y Sonia Mariño.
Un modelo que no inventa
Los grandes modelos de lenguaje pueden tener un impacto fuerte en el ámbito legal, porque el trabajo del abogado maneja mucha información en forma de texto. El sistema desarrollado por el grupo de la UNNE utiliza una base de datos cerrada, con documentos específicos, para evitar las llamadas “alucinaciones”.
En lugar de buscar información en cualquier fuente, el modelo trabaja con una base predeterminada que contiene únicamente la jurisprudencia de interés. Según Pulido, sin esa restricción el modelo puede encontrar información de otros países o de otras provincias y no dar una respuesta precisa.
Dada una pregunta, el modelo genera búsquedas en esa base para identificar los documentos de interés y luego elabora las respuestas a partir de la documentación relevante específica.
Smulever fue becario de las becas IA de la UNNE, promovidas por la Secretaría General de Ciencia y Técnica de la institución. Actualmente es becario doctoral del CONICET, bajo la dirección de Pulido.
El becario explicó que el trabajo busca que la respuesta del modelo de lenguaje corresponda al contenido jurídico que el usuario pretende al hacer una consulta. Los usuarios que darán máxima utilidad al modelo son los profesionales del Derecho y funcionarios públicos.
Detalló el mecanismo interno que el sistema realiza después de la consulta: desglosa y estructura la pregunta, extrae sus entidades y las vincula con la base de datos. Con esa vinculación filtra los documentos relevantes y realiza una búsqueda semántica sobre el conjunto filtrado.
La base incluye jurisprudencia, normativa y documentos doctrinarios. Smulever indicó que el objetivo es reunir el universo jurídico completo, porque en el Derecho «todo se relaciona con todo»: la jurisprudencia se basa en normativa y los documentos doctrinarios analizan jurisprudencia y normas.
Como ejemplo, planteó el caso de un abogado litigante que consulta por juicios contra el “abuso de autoridad”. La consulta se formula como en cualquier chat con un modelo de lenguaje de uso general, como ChatGPT. El sistema identifica primero el tipo de documento: «juicio» remite a jurisprudencia, lo que constituye el primer filtro. Luego identifica la figura legal, en este caso el abuso de poder, que acota de nuevo la búsqueda. Después busca semánticamente lo relevante dentro de los documentos filtrados.
Resúmenes y poder de cómputo
Luciana Belén Canteros es de Ituzaingó, Corrientes, y es becaria del programa de becas sobre IA de la UNNE. Trabajó en la generación de resúmenes y en comparativas para determinar qué modelo es más apropiado para esa tarea.
Indicó que obtener métricas para decidir qué resumen es mejor que otro es difícil, porque se trata de texto, y que ese fue uno de los desafíos. Los documentos legales tienen una extensión que demanda poder computacional para procesarlos y tiempo para que una persona del ámbito legal los lea, por lo que los resúmenes tienen un uso central en el proyecto.
Smulever agregó que las búsquedas semánticas mejoran cuando se dispone de resúmenes de calidad.
Los becarios destacaron el soporte fundamental del Centro de Cómputos de Alta Performance del NEA (CECONEA). El equipo realiza el entrenamiento y uso de los modelos, así como el almacenamiento y procesamiento de las bases de datos bajo estrictos protocolos de seguridad, utilizando servidores y GPU propios dentro de la UNNE en el CECONEA.
El aislamiento de la base de datos y el modelo es fundamental para proteger la información sensible y reducir el riesgo de uso no autorizado, extracción de información por chats comerciales y ataques informáticos.
Convenios con empresas y el Poder Judicial del Chaco
Pulido afirmó que los resultados de los proyectos de investigación del Área de Machine Learning e Inteligencia Artificial se aplican luego dentro de convenios de vinculación con organismos y empresas, con el propósito de que tengan impacto regional y nacional.
El grupo tiene vinculación con empresas, en general startups dedicadas al ámbito legal, entre las que cabe citar SEGEM SA, IJ-ILG SA y Legalhub SA. El objetivo es usar modelos de inteligencia artificial para facilitar las tareas de los estudios jurídicos y automatizar procesos. En estudios con muchos casos, hay tareas repetitivas que el modelo puede resolver de forma automática.
El grupo también trabaja con el Poder Judicial del Chaco en un proyecto para desarrollar una plataforma inteligente basada en estas investigaciones. Pulido precisó que la plataforma usa bases de datos cerradas y modelos de lenguaje de código abierto, con lo cual la información queda dentro del sistema y se garantiza la confidencialidad del trabajo del Poder Judicial.
El investigador afirmó que este punto cobra relevancia por el uso de modelos de lenguaje abiertos con información delicada, como ChatGPT de OpenAI o Claude de Anthropic. Según indicó, en esos sistemas la información que el usuario sube puede ser reutilizada por los modelos para su aprendizaje.
Finalmente, los becarios y Pulido manifestaron satisfacción por los resultados obtenidos en la línea de las becas IA y por el reconocimiento de la conferencia, que interpretaron como una señal de que el trabajo tiene impacto.
Qué son las JAIIO
Las JAIIO (Jornadas Argentinas de Informática) son el evento y las jornadas de informática más antiguas de Argentina, organizadas de forma ininterrumpida desde 1961 por la Sociedad Argentina de Informática (SADIO).
Reúne a investigadores, estudiantes, docentes, profesionales y referentes de la academia, la industria y el sector público para debatir, compartir experiencias y difundir los avances en la disciplina informática.
Los trabajos evaluados por comités de expertos se publican en las Memorias de las JAIIO, y las versiones extendidas más destacadas aparecen en el Electronic Journal of SADIO (EJS).